初版构建工具
Grunt
Grunt可以说是前端(JS语言)中第一个正式的构建工具,它基于 Node.js ,用 JS 开发,这样就可以借助 Node.js 实现跨系统跨平台的桌面端的操作,例如文件操作等等。此外,Grunt 以及插件都作为一个 包 ,可以用 NPM 安装进行管理,但对于像webpack上很多能力,如HMR、Scope Hoist等都是不支持的,可以作为学习webpack前的了解。
Grunt其实更像是一种自动化的配置工具集,就像官方说的,Grunt是The JavaScript Task Runner,使用上,Grunt 是由 JSON 配置设置驱动,并且每个 Grunt 任务通常必须创建中间文件将结果传递给其他任务。
所能实现的功能包括:检查每个 JS 文件语法、合并两个 JS 文件、将合并后的 JS 文件压缩、将 SCSS 文件编译等,包括我们上面提到的试用gulp将.less文件转换为.css文件等等。
Gulp
Gulp跟Grunt类似,都是基于task驱动执行的,可以完成javascript/coffee/sass/less/html/image/css 等文件的的测试、检查、合并、压缩、格式化、浏览器自动刷新、部署文件生成。Gulp的优点在于Gulp更倾向于写代码的方式,但相关的插件资源不如Grunt。
现代打包构建工具基石--webpack
webpack配置
Entry
entry是配置模块的入口,可抽象成输入,Webpack 执行构建的第一步将从入口开始搜寻及递归解析出所有入口依赖的模块。 entry 配置是必填的,若不填则将导致 Webpack 报错退出。
Entry类型
| 类型 | 例子 | 含义 |
|---|---|---|
| string | './src/index.js' | 单入口,入口文件为字符串,可以是相对路径,也可以是绝对路径 |
| array | ['./src/index.js', './src/index2.js'] | 多入口,入口文件为数组,数组中的每个元素都是入口文件 |
| object | 多入口,入口文件为对象,对象中的每个属性名都是入口名称,属性值是入口文件,每个入口生成一个chunk |
Chunk名称 Webpack 会为每个生成的 Chunk 取一个名称,Chunk 的名称和 Entry 的配置有关:
- 如果 entry 是一个
string或array,就只会生成一个 Chunk,这时 Chunk 的名称是main; - 如果 entry 是一个
object,就可能会出现多个 Chunk,这时 Chunk 的名称是object键值对里键的名称;
动态配置Entry 假如项目里有多个页面需要为每个页面的入口配置一个 Entry ,但这些页面的数量可能会不断增长,则这时 Entry 的配置会受到到其他因素的影响导致不能写成静态的值。其解决方法是把 Entry 设置成一个函数去动态返回上面所说的配置,代码如下:
// 同步函数
entry: () => {
  return {
    a:'./pages/a',
    b:'./pages/b',
  }
};
// 异步函数
entry: () => {
  return new Promise((resolve)=>{
    resolve({
       a:'./pages/a',
       b:'./pages/b',
    });
  });
};
Output
output 配置如何输出最终想要的代码。output 是一个 object,里面包含一系列配置项:
filename
// 如果只有一个输出文件,则可以把它写成静态不变的
filename: 'bundle.js'
//但是在有多个 Chunk 要输出时,就需要借助模版和变量
filename: '[name].js'
内置变量
| 变量名 | 含义 |
|---|---|
| [id] | Chunk 的唯一标识符,从 0 开始 |
| [name] | chunk 的名称(如果未指定名称,则为 chunk ID) |
| [hash] | 根据整个构建过程生成的哈希值,用于缓存控制。 |
| [chunkhash] | 根据 chunk 内容生成的哈希值,用于缓存控制(不推荐使用,建议使用 [contenthash] |
| [contenthash] | 根据 chunk 内容生成的哈希值,用于缓存控制。 |
其中 hash 和 chunkhash 的长度是可指定的,[hash:8] 代表取8位 Hash 值,默认是20位。
chunkFilename
用于指定非入口(non-entry)chunk 文件名的参数,这些 chunk 文件通常是由动态导入(如 import() 语法)或代码拆分(如 SplitChunksPlugin)生成的。
module.exports = {
  output: {
    filename: '[name].[contenthash].js', // 入口 chunk 文件名
    chunkFilename: '[name].[contenthash].chunk.js', // 非入口 chunk 文件名
    path: path.resolve(__dirname, 'dist')
  }
};
动态导入(Dynamic Import)
动态导入是 Webpack 中常用的代码拆分方式之一。通过 import() 语法,可以将代码拆分为多个 chunk 文件,从而实现按需加载。
假设项目结构如下:
project/
├── src/
│   ├── index.js
│   └── utils/
│       └── helper.js
├── dist/
└── webpack.config.js
index.js 文件内容如下:
import('./utils/helper').then(module => {
  console.log(module.default);
});
webpack.config.js 配置如下:
const path = require('path');

module.exports = {
  entry: './src/index.js',
  output: {
    filename: '[name].[contenthash].js',
    chunkFilename: '[name].[contenthash].chunk.js',
    path: path.resolve(__dirname, 'dist')
  }
};
打包结果:
- 入口 chunk 文件:
main.[contenthash].js - 动态导入生成的 chunk 文件:
src_utils_helper_js.[contenthash].chunk.js
代码拆分(Code Splitting)
代码拆分是 Webpack 中的一种优化策略,它可以将代码拆分为多个 chunk 文件,从而减少初始加载时间。代码拆分可以通过多种方式实现,包括动态导入、SplitChunksPlugin 等。
示例: 假设项目结构如下:
project/
├── src/
│   ├── index.js
│   ├── moduleA.js
│   └── moduleB.js
├── dist/
└── webpack.config.js
webpack.config.js 配置如下:
const path = require('path');

module.exports = {
  entry: './src/index.js',
  output: {
    filename: '[name].[contenthash].bundle.js',
    path: path.resolve(__dirname, 'dist'),
    clean: true,
  },
  optimization: {
    splitChunks: {
      chunks: 'all',
      minSize: 20000,
      maxSize: 0,
      minChunks: 1,
      maxAsyncRequests: 10,
      maxInitialRequests: 5,
      automaticNameDelimiter: '~',
      name: true,
      cacheGroups: {
        vendors: {
          test: /[\\/]node_modules[\\/]/,
          priority: -10,
        },
        default: {
          minChunks: 2,
          priority: -20,
          reuseExistingChunk: true,
        },
      },
    },
  },
};
打包结果:
main.8d63578b.bundle.js:这是主应用代码的打包文件。runtime~main.8d63578b.bundle.js:这是 Webpack 的运行时代码,用于支持动态加载等功能。vendor.8d63578b.bundle.js:这是第三方库(如 React 和 lodash)的打包文件。 通过SplitChunksPlugin,Webpack会自动将公共代码和第三方库分离出来,形成单独的vendor块。这有助于优化加载时间和利用缓存机制。
path
output.path 配置输出文件存放在本地的目录,必须是 string 类型的绝对路径。通常通过 Node.js 的 path 模块去获取绝对路径:
path: path.resolve(__dirname, 'dist_[hash]')publicPath
在复杂的项目里可能会有一些构建出的资源需要异步加载,加载这些异步资源需要对应的 URL 地址。 output.publicPath 配置发布到线上资源的 URL 前缀,为string 类型。 默认值是空字符串 '',即使用相对路径。 这样说可能有点抽象,举个例子,需要把构建出的资源文件上传到 CDN 服务上,以利于加快页面的打开速度。配置代码如下
filename:'[name]_[chunkhash:8].js'
publicPath: 'https://cdn.example.com/assets/'
这时发布到线上的 HTML 在引入 JavaScript 文件时就需要:
<script src='https://cdn.example.com/assets/a_12345678.js'></script>使用该配置项时要小心,稍有不慎将导致资源加载404错误。 output.path 和 output.publicPath 都支持字符串模版,内置变量只有一个:hash 代表一次编译操作的 Hash 值。
crossOriginLoading
Webpack 输出的部分代码块可能需要异步加载,而异步加载是通过 JSONP 方式实现的。 JSONP 的原理是动态地向 HTML 中插入一个 <script src="url"></script> 标签去加载异步资源。 output.crossOriginLoading 则是用于配置这个异步插入的标签的 crossorigin 值。
anonymous(默认) 在加载此脚本资源时不会带上用户的Cookies;use-credentials在加载此脚本资源时会带上用户的Cookies;
libraryTarget 和 library
当用 Webpack 去构建一个可以被其他模块导入使用的库时需要用到它们。
output.libraryTarget配置以何种方式导出库;output.library配置导出库的名称;
Module
rules
rules 配置模块的读取和解析规则,通常用来配置 Loader。其类型是一个数组,数组里每一项都描述了如何去处理部分文件。 配置一项 rules 时大致通过以下方式:
- 条件匹配:通过 test 、 include 、 exclude 三个配置项来命中 Loader 要应用规则的文件;(支持字符串/正则/路径数组)
- 应用规则:对选中后的文件通过 use 配置项来应用 Loader,可以只应用一个 Loader 或者按照从后往前的顺序应用一组 Loader,同时还可以分别给 Loader 传入参数;
- 重置顺序:一组 Loader 的执行顺序默认是从右到左执行,通过 enforce 选项可以让其中一个 Loader 的执行顺序放到最前或者最后;
module: {
  rules: [
    {
      // 命中 JavaScript 文件
      test: /\.js$/,
      // 用 babel-loader 转换 JavaScript 文件
      // ?cacheDirectory 表示传给 babel-loader 的参数,用于缓存 babel 编译结果加快重新编译速度
      use: ['babel-loader?cacheDirectory'],
      // 只命中src目录里的js文件,加快 Webpack 搜索速度
      include: path.resolve(__dirname, 'src')
    },
    {
      // 命中 SCSS 文件
      test: /\.scss$/,
      // 使用一组 Loader 去处理 SCSS 文件。
      // 处理顺序为从后到前,即先交给 sass-loader 处理,再把结果交给 css-loader 最后再给 style-loader。
      use: ['style-loader', 'css-loader', 'sass-loader'],
      // 排除 node_modules 目录下的文件
      exclude: path.resolve(__dirname, 'node_modules'),
    },
    {
      // 对非文本文件采用 file-loader 加载
      test: /\.(gif|png|jpe?g|eot|woff|ttf|svg|pdf)$/,
      use: ['file-loader'],
    },
  ]
}
在 Loader 需要传入很多参数时,你还可以通过一个 Object 来描述,例如在上面的 babel-loader 配置中有如下代码:
use: [
  {
    loader:'babel-loader',
    options:{
      cacheDirectory:true,
    },
    // enforce:'post' 的含义是把该 Loader 的执行顺序放到最后
    // enforce 的值还可以是 pre,代表把 Loader 的执行顺序放到最前面
    enforce:'post'
  },
  // 省略其它 Loader
]
noParse
noParse 配置项可以让 Webpack 忽略对部分没采用模块化的文件的递归解析和处理,这样做的好处是能提高构建性能。 原因是一些库例如 jQuery 、ChartJS 它们庞大又没有采用模块化标准,让 Webpack 去解析这些文件耗时又没有意义。 noParse 是可选配置项,类型需要是 RegExp、[RegExp]、function 其中一个。 注意被忽略掉的文件里不应该包含 import 、 require 、 define 等模块化语句,不然会导致构建出的代码中包含无法在浏览器环境下执行的模块化语句。
// 使用正则表达式
noParse: /jquery|chartjs/

// 使用函数,从 Webpack 3.0.0 开始支持
noParse: (content)=> {
  // content 代表一个模块的文件路径
  // 返回 true or false
  return /jquery|chartjs/.test(content);
}
parse
parser属性可以更细粒度的配置哪些模块语法要解析哪些不解析,和 noParse 配置项的区别在于 parser 可以精确到语法层面, 而 noParse 只能控制哪些文件不被解析
module: {
  rules: [
    {
      test: /\.js$/,
      use: ['babel-loader'],
      parser: {
        amd: false, // 禁用 AMD
        commonjs: false, // 禁用 CommonJS
        system: false, // 禁用 SystemJS
        harmony: false, // 禁用 ES6 import/export
        requireInclude: false, // 禁用 require.include
        requireEnsure: false, // 禁用 require.ensure
        requireContext: false, // 禁用 require.context
        browserify: false, // 禁用 browserify
        requireJs: false, // 禁用 requirejs
      }
    },
  ]
}
Resolve
Webpack 在启动后会从配置的入口模块出发找出所有依赖的模块,Resolve 配置 Webpack 如何寻找模块所对应的文件。
alias
resolve.alias 配置项通过别名来把原导入路径映射成一个新的导入路径
// Webpack alias 配置
resolve:{
  alias:{
    components: './src/components/'
  }
}
当你通过 import Button from 'components/button' 导入时,实际上被 alias 等价替换成了 import Button from './src/components/button'。
mainFields
有一些第三方模块会针对不同环境提供几分代码。 例如分别提供采用 ES5 和 ES6 的2份代码,这2份代码的位置写在 package.json 文件里,如下:
{
  "jsnext:main": "es/index.js",// 采用 ES6 语法的代码入口文件
  "main": "lib/index.js" // 采用 ES5 语法的代码入口文件
}
Webpack 会根据 mainFields的配置去决定优先采用那份代码,按照数组顺序只会使用找到的第一个,mainFields 默认如下:
mainFields: ['browser', 'main']假如你想优先采用 ES6 的那份代码,可以这样配置:
mainFields: ['jsnext:main', 'browser', 'main']extensions
在导入语句没带文件后缀时,Webpack 会自动带上后缀后去尝试访问文件是否存在。 resolve.extensions 用于配置在尝试过程中用到的后缀列表,会按照顺序去尝试。默认是:
extensions: ['.js', '.json']modules
resolve.modules 配置 Webpack 去哪些目录下寻找第三方模块,默认是只会去 node_modules目录下寻找
modules:['./src/components','node_modules']descriptionFiles
resolve.descriptionFiles 配置描述第三方模块的文件名称,也就是 package.json 文件。默认如下:
descriptionFiles: ['package.json']基于webpack改进的构建工具
Rollup
rollup相对webpack更轻量,其构建的代码并不会像webpack一样被注入大量的webpack内部结构,而是尽量的精简保持代码原有的状态。且配置相对简单,但因为没有devServer和HMR,所以一般rollup用于JS库开发,而非业务开发。
webpack诞生于ESM标准出来前,CommonJs出来后,当时的浏览器只能通过script标签加载模块
script标签加载代码是没有作用域的,只能在代码内 用IIFE的方式 实现作用域效果, 这就是webpack打包出来的代码 大结构都是IIFE的原因,并且每个模块都要装到function里面,才能保证互相之间作用域不干扰。这就是为什么 webpack打包的代码为什么乍看会感觉乱,找不到自己写的代码的真正原因。同时,webpack的代码注入问题,是因为浏览器不支持cjs,所以webpack要去自己实现require和module.exports方法(才有很多注入)(webpack自己实现polyfill)
rollup诞生于esm标准出来后,可以充分使用上esm的tree shaking,也没有历史包袱,所以可以做到真正的“打包”(精简,无额外注入)
Parcel
Parcel只能说是时代的产物,Parcel的code splitting、HMR、sourcemap、publicPath、tree shaking、scope hoist、share module、UMD等基本的能力还是提供了的,而且官方也在不断的维护,建议简单项目可以尝试使用。
特点
- 完全零配置
- 构建速度更快
- 自动安装依赖,开发更加便捷
突破JS语言特性的构建工具
SWC
SWC意指(Speedy Web Compiler)快速的web编译器,是用RUST实现的。主要针对JS使用了多线程的能力。
我们知道,Webpack与Babel的性能瓶颈都在于JS语言,出现了go实现的Esbuild与Rust实现的SWC等工具,其中,SWC的目标则是是替代babel,本身是为了对标babel进行设计的,可以看到大部分babel的功能SWC也对标实现了。
esbuild
使用Go
JavaScript 本质上依然是一门解释型语言,JavaScript 程序每次执行都需要先由解释器一边将源码翻译成机器语言,一边调度执行;而 Go 是一种编译型语言,在编译阶段就已经将源码转译为机器码,启动时只需要直接执行这些机器码即可。也就意味着,Go 语言编写的程序比 JavaScript 少了一个动态解释的过程。
多线程 JavaScript 本质上是一门单线程语言,在运行时层面,Go 拥有天然的多线程能力,更高效的内存使用率,也就意味着更高的运行性能。
全量定制 在 Webpack、Rollup 这类工具中,比如:
- 使用 babel 实现 ES 版本转译;
- 使用 eslint 实现代码检查;
- 使用 TSC 实现 ts 代码转译与代码检查;
- 使用 less、stylus、sass 等 css 预处理工具; 这些全部都是插件实现,其实目前我们已经完全习惯了这种方式,甚至觉得事情就应该是这样的,大多数人可能根本没有意识到事情可以有另一种解决方案。Esbuild 起了个头,选择完全重写,整套编译流程所需要用到的所有工具全部重写,这意味着它需要重写 js、ts、jsx、json 等资源文件的加载、解析、链接、代码生成逻辑。
开发成本很高,而且可能被动陷入封闭的风险,但收益也是巨大的,它可以一路贯彻原则,以性能为最高优先级定制编译的各个阶段,比如说:
- 重写 ts 转译工具,完全抛弃 ts 类型检查,只做代码转换;
- 大多数打包工具把词法分析、语法分析、符号声明等步骤拆解为多个高内聚低耦合的处理单元,各个模块职责分明,可读性、可维护性较高。而 Esbuild 则坚持性能第一原则,不惜采用反直觉的设计模式,将多个处理算法混合在一起降低编译过程数据流转所带来的性能损耗;
- 一致的数据结构,以及衍生出的高效缓存策略; 这种深度定制一方面降低了设计成本,能够保持编译链条的架构一致性;一方面能够贯彻性能第一的原则,确保每个环节以及环节之间交互性能的最优。虽然伴随着功能、可读性、可维护性层面的的牺牲,但在编译性能方面几乎做到了极致。
结构一致性 在 Webpack 中使用 babel-loader 处理 JavaScript 代码时,可能需要经过多次数据转换:
- Webpack 读入源码,此时为字符串形式
- Babel 解析源码,转换为 AST 形式
- Babel 将源码 AST 转换为低版本 AST
- Babel 将低版本 AST generate 为低版本源码,字符串形式
- Webpack 解析低版本源码
- Webpack 将多个模块打包成最终产物 源码需要经历
string => AST => AST => string => AST => string,在字符串与 AST 之间反复横跳。
而 Esbuild 重写大多数转译工具之后,能够在多个编译阶段共用相似的 AST 结构,尽可能减少字符串到 AST 的结构转换,提升内存使用效率。
但与完全重写相对的是,目前Esbuild对于很多功能(像Vue、Angular等)支持还在逐步实现中,所以在线上环境还为时过早,但就纯编译性能上看,Esbuild可以极具竞争力,这也是为什么像Vite、snowpack选择Esbuild编译的原因。
但看官网作者貌似很坚持自己的想法,对于降级ES5、模块联邦、Vue、HMR等都不打算添加,所以线上环境还是建议使用基于Esbuild的上层框架,如Vite等
基于ES Module的bundleless(no bundle)构建工具
浏览器对于HTTP2和ESM的支持,使得我们可以减少模块的合并,以及减少对于js模块化的处理。
- 如果浏览器支持HTTP2,那么一定程度上,我们不需要合并静态资源;
- 如果浏览器支持ESM,那么我们就不需要通过构建工具去维护复杂的模块依赖和加载关系; 这两点正是webpack等打包工具在bundle的时候所做的事情。浏览器对于HTTP2和ESM的支持使得我们减少bundle代码的场景。
Snowpack
Vite
Vite原理
开发环境
不需要对所有资源打包,只是使用esbuild对依赖进行预构建,将CommonJS和UMD发布的依赖转换为浏览器支持的ESM
Vite会将于构建的依赖缓存到node_modules/.vite目录下,它会根据几个源来决定是否需要重新运行预构建,包括 packages.json中的dependencies列表、包管理器的lockfile、可能在vite.config.js相关字段中配置过的。只要三者之一发生改变,才会重新预构建;
开发环境使用了浏览器缓存技术,解析后的依赖请求以http头的max-age=31536000,immutable强缓存,以提高页面性能;
生成环境
使用rollup来完成整个打包过程,虽然esbuild构建速度很快,但是目前不支持ES5的产出,所以选择更加稳定的rollup;
为了在生产环境中获得最佳的加载性能,仍然需要对代码进行tree-shaking、懒加载以及chunk分割(以获得更好的缓存)。
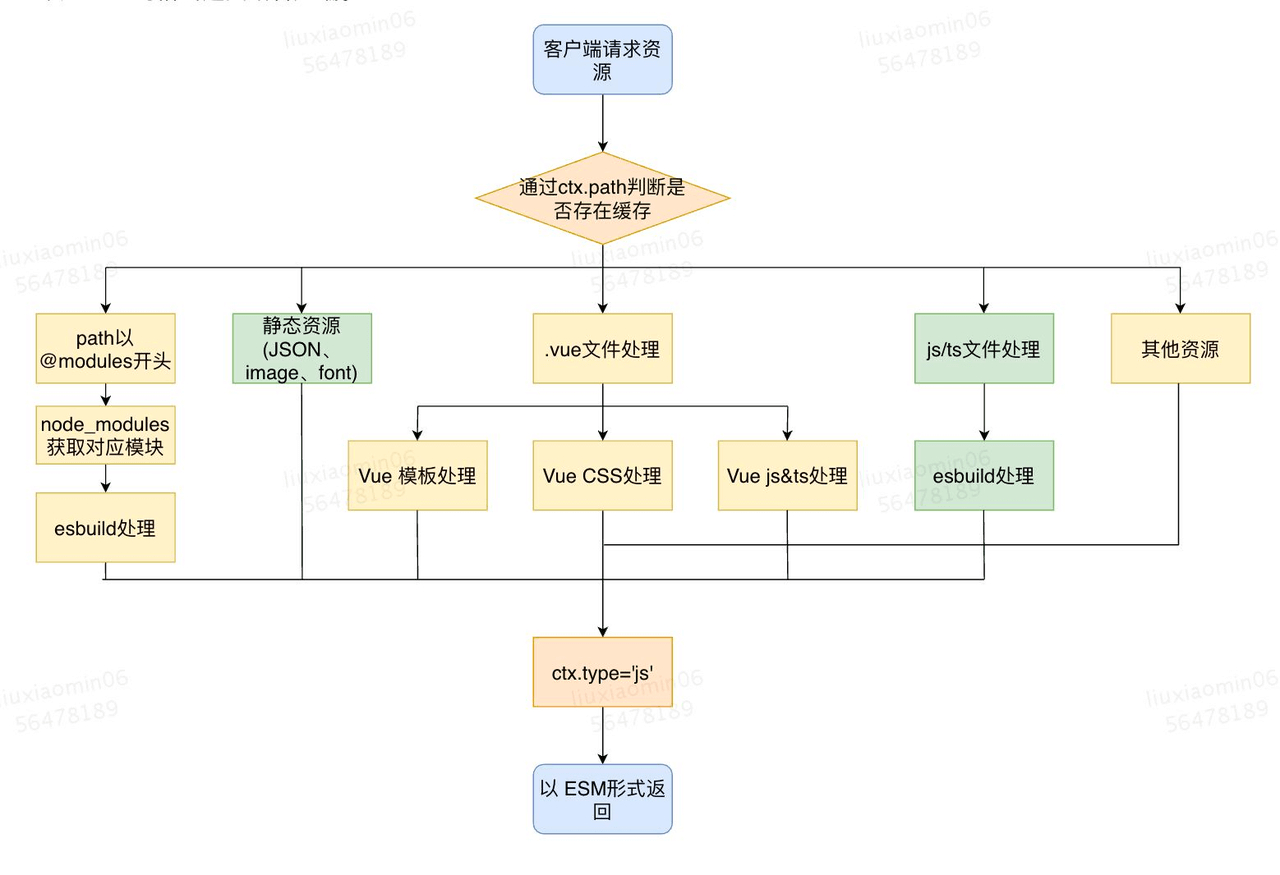
开发环境核心原理--请求拦截
启动一个 koa 服务器拦截由浏览器请求 ESM的请求。通过请求的路径找到目录下对应的文件做一定的处理最终以 ESM的格式返回给客户端。