前端缓存不只是“提高速度”,它还决定了:资源更新是否及时、页面刷新为什么还在命中缓存、以及登录态为什么能跨会话保持。把 HTTP 缓存与浏览器缓存串起来,你会发现很多现象都有流程与公式可推导。
先把话说清:前端缓存到底是什么?
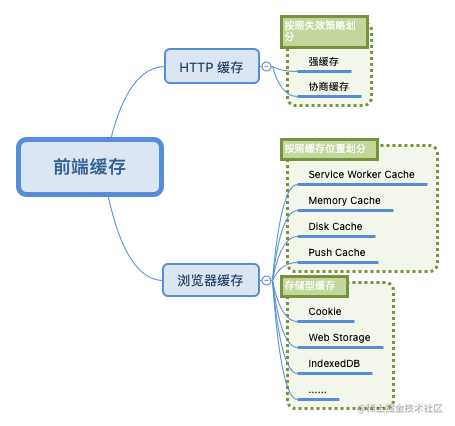
在前端工程里,我们通常把缓存理解为 HTTP 缓存 + 浏览器缓存 的组合,并进一步可按位置/策略拆分:
- 资源缓存(缓存静态资源,目标是“资源是否需要重新获取”)
- 数据缓存(缓存常用数据,目标是“下次是否还需要重复请求/重复登录”)
- 强缓存 / 协商缓存(按 HTTP 失效与验证方式划分)
- Service Worker Cache / Memory Cache / Disk Cache / Push Cache(按浏览器缓存位置划分)
- 存储型缓存:Cookie / Web Storage / IndexedDB(按数据存储介质划分)
接下来按“资源缓存(HTTP)-> 浏览器缓存(内存/磁盘/SW)-> 存储型缓存(Cookie/WebStorage/IndexedDB)-> 工程落地(Nginx/调试)”的顺序,把整套链路讲清楚。
资源缓存:HTTP 强缓存与协商缓存
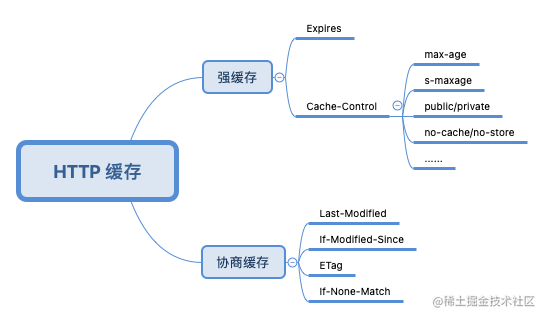
HTTP 是请求-响应协议,浏览器和服务器之间的缓存能力主要体现在请求/响应头的“首部字段”上。资源缓存可以拆成两类:
- 强缓存:命中则直接从本地读取,不需要再请求服务器
- 协商缓存:强缓存失效后携带缓存标识向服务器校验;若未更新,服务器返回
304 Not Modified,浏览器仍使用本地缓存
强缓存:Expires 与 Cache-Control
Expires(HTTP/1.0,绝对时间)
Expires 描述缓存过期的绝对时间:
Expires: Wed, 11 May 2018 07:20:00 GMT因为它是绝对时间,可能受本地时间影响:如果缓存期间修改了客户端时间,缓存判断可能失真。
Cache-Control(HTTP/1.1,相对时间)
Cache-Control 描述缓存行为,常用指令如 max-age、s-maxage、public/private、no-cache/no-store 等。
示例:
Cache-Control: max-age=3600, s-maxage=3600, public
Cache-Control: no-cache
关键理解:
max-age是相对时间(秒),表示从响应生成后,缓存新鲜度持续多久s-maxage面向公共缓存(例如 CDN/代理缓存),出现时通常会覆盖max-agepublic/private控制谁能缓存:public允许中间代理;private只允许客户端缓存no-cache与no-store都和“是否直接用缓存”有关,但在响应头里真正影响“是否落地缓存”的是no-store
强缓存的“是否新鲜”公式
强缓存像食品有保质期一样,也有“新鲜度”。可以用:
强缓存是否新鲜 = 缓存新鲜度 > 缓存使用期其中:
- 缓存新鲜度(由
max-age或expires推算)
缓存新鲜度 = max-age || (expires - date)- 缓存使用期(考虑响应创建时间、传输延迟、以及资源在本地停留的时间)
缓存使用期 = 响应使用期 + 传输延迟时间 + 停留缓存时间响应使用期与下列字段相关:
age:响应首部Age(秒级),表示推算资源创建经过时间date:响应首部Date(绝对时间)request_time/response_time/now:同样来自客户端本地时间
因此一旦把客户端时间调到未来,停留缓存时间计算会变大,进而导致“使用期 > 新鲜度”,强缓存失效。
启发式缓存(当强缓存字段缺失)
如果响应头里既没有 max-age/s-maxage,也没有 expires,但存在 last-modified,浏览器会触发“启发式缓存”,用经验规则估算新鲜度:
缓存新鲜度 = max(0, (date - last-modified)) * 10%协商缓存:生效流程与缓存标识
协商缓存可以理解为:强缓存失效后,浏览器携带“缓存标识”去请求服务器,让服务器判断这份资源是否更新。
协商缓存常用两组字段:
Last-Modified/If-Modified-SinceETag/If-None-Match
并且当两者同时出现时,ETag 优先级更高。
Last-Modified 的问题
- 以秒为单位,修改频率很高时可能误判(秒内变化无法区分)
- 服务器资源“改了时间但内容没变”时,可能导致不必要刷新
ETag 的优势与实现(强/弱 ETag)
ETag 是资源唯一标识,常见生成方式包括:
- 使用文件大小与修改时间
- 对内容做 hash,并结合内容长度
ETag 也区分强/弱校验:
- 强 ETag:内容任意细微变化都会改变
- 弱 ETag:只用于提示资源大体是否相同,值前缀可能带
W/
理解 ETag 原理的意义在于:它让协商校验更精准,浏览器也能更精确地决定缓存是否复用。
前端应用中的 HTTP 缓存方案(SPA + hash)
在 SPA 中:
- 首屏的
HTML通常需要“尽快验证版本”,否则发布新版本后旧HTML可能导致资源引用不匹配 - JS/CSS/图片这类“构建产物”可以通过 hash 命名,让内容变化就变 URL,从而强缓存友好复用
因此形成一套典型方案:
- 频繁变动资源(例如
HTML):使用协商缓存 - 相对稳定静态资源(JS/CSS/图片):使用强缓存,并通过 hash 命名避免“内容没变却 URL 仍被当成旧资源”
webpack 的 hash 三种类型:hash / chunkhash / contenthash
hash:项目级别,只要项目任意地方变化,所有产物 hash 可能一起变化,容易造成无谓重拉chunkhash:入口/chunk 级别,粒度更细,常用于隔离不同入口产物contenthash:内容级别,更适合解决“某个入口修改导致不该变的资源也一起变”的问题
在配合缓存策略时,一般会强调:
- 最大化强缓存命中,需要把“变化粒度”控制在尽可能小的范围
HTML 协商缓存:让版本更新及时生效
一种典型做法是让 HTML 在短期内失效后走协商校验:
Cache-Control: max-age=0
Last-Modified: Sat, 04 Sep 2021 08:59:40 GMT
在强缓存很快失效的情况下,浏览器会触发协商缓存校验,减少“旧 HTML 仍被复用”的风险。
浏览器缓存:Memory Cache 与 Disk Cache
HTTP 决定“能不能用缓存”;浏览器缓存决定“缓存在哪里、读多快”。在浏览器里,资源本地缓存可理解为:
- Memory Cache(内存缓存):快(可视为
0ms),但生命周期短(关闭 Tab 后释放),受内存大小限制 - Disk Cache(磁盘缓存):慢一些,但生命周期更长(未清理通常持续存在)
缓存获取顺序:三级缓存理解
当资源准备加载时,可按三级缓存理解:
- 先找内存缓存
- 再找磁盘缓存
- 都没有就走网络请求,并把结果写入可用的本地缓存层
因此在开发者工具里看到 from memory cache / from disk cache,本质上是浏览器本地缓存命中的体现。
为什么资源“看起来像没命中”?
来源材料给出的关键观察是:资源是否进入 Memory Cache 与“资源加载/执行/渲染时机”有关。
例如:
- 有些资源在 HTML 渲染阶段就触发加载,更容易进入内存缓存
- 异步加载/延迟执行的脚本等,可能改变最终进入内存/磁盘的概率分布
base64图片在实际观察中经常表现得更“固执”,很多场景都从内存读取
此外:
preload与prefetch会影响资源的拉取时机,进而影响命中内存/磁盘缓存的表现
用户操作与缓存:Chrome 三种加载模式
很多“为什么我刷新了还在缓存”的疑惑来自浏览器刷新触发的加载模式不同。
Chrome 在开发者工具打开时,可以触发三种常见模式(材料以三种归纳):
- 正常重新加载:更多资源命中内存缓存(
memory cache),刷新更像“优先读缓存” - 硬性重新加载(强制刷新):不会清空本地缓存,但会在请求头加入类似
Cache-Control: no-cache与Pragma: no-cache来禁用直接使用缓存,效果类似于 DevTools 的Disable cache - 清空缓存并硬性重新加载:会清空站点本地存储后再请求网络
为什么 Ctrl + F5 仍可能命中缓存?
材料给出的解释与验证思路是:硬性重新加载并不会清空缓存;若页面脚本在之后异步插入资源,资源加载发生的阶段可能仍允许强缓存命中。
这也解释了为什么材料强调:
Disable cache是在更早阶段直接禁用缓存读取,所以异步资源不会再读缓存- 单纯的 Ctrl + F5 不等价于“彻底禁用并清空”
Service Worker:用渐进增强把缓存交给前端
Service Worker 是一种用 JavaScript 编写的脚本,它作为独立线程运行,能控制网络请求、管理缓存、实现离线访问。
它服务于 PWA(渐进式 Web 应用)的核心目标:即使网络条件变化,用户仍能获得可靠体验。
生命周期:注册 / 安装 / 激活
常见流程:
- 注册
register:指定scope,决定拦截范围 - 安装
install:下载并预缓存部分资源(可用skipWaiting()让新 SW 更快激活) - 激活
activate:清理过期缓存,并可通过clients.claim()让新 SW 尽快控制页面
拦截请求:缓存优先 + 网络回退
材料中给出的示意逻辑是:
- 在
fetch事件中拦截请求 - 优先从缓存中匹配
- 缓存里没有则走网络请求,并把结果写入 runtime 缓存
示意代码要点:
// sw.js
self.addEventListener('fetch', (event) => {
  // 仅处理同源请求(跨域资源可按需扩展)
  if (!event.request.url.startsWith(self.location.origin)) return;

  event.respondWith(
    caches.match(event.request).then((cachedResponse) => {
      if (cachedResponse) return cachedResponse;

      return fetch(event.request).then((response) => {
        return caches.open('runtime').then((cache) => {
          cache.put(event.request, response.clone());
          return response;
        });
      });
    })
  );
});
兼容性与安全限制
- 不同浏览器/版本支持程度不同,需要渐进增强
- 为了安全,Service Worker 只能在
https与localhost下使用
Workbox:更高层的 Service Worker 缓存策略
材料提到 Workbox 可以简化 Service Worker 开发,并给出了常用策略:
staleWhileRevalidate:先回缓存,同时后台发起网络更新networkFirst:网络优先cacheFirst:缓存优先,缓存没有再网络networkOnly:只网络,不缓存cacheOnly:只读缓存,不网络
浏览器存储型缓存:Cookie / Web Storage / IndexedDB
资源缓存解决“要不要重新拉”;存储型缓存解决“要不要重新登录/重新计算”。
网站登录背后的存储逻辑
登录后维持状态的关键是 token 的存取与传输。
材料给出两类常见方式:
- 服务端自动植入:登录接口返回
Set-Cookie,后续同域请求自动携带 cookie - 前端手动存储:服务端把 token 返回给前端,前端存入
localStorage等;请求时前端自己把 token 放到自定义请求头里
Cookie 存储方案
Cookie 的设计初衷主要是身份识别与状态维持,并非大数据存储。
材料重点包括:
- 容量限制较小(材料提到约 4KB)
- 不建议存大量非用户身份数据,因为 cookie 会随请求头发给服务端
- 建议使用封装库
js-cookie,避免直接拼接document.cookie带来的繁琐与错误风险
材料中的 js-cookie API 示例:
import Cookies from 'js-cookie'

Cookies.set('name', 'juejin', { domain: 'juejin.cn' })
Cookies.get('name')
Cookies.remove('name')
Web Storage:localStorage / sessionStorage
材料中的结论:
sessionStorage:会话级别,关闭标签/页面后清理localStorage:持久化,除非手动删除或过期逻辑生效
以及一个重要限制:
- 存储最终以字符串落地,存对象需要序列化(
JSON.stringify)与反序列化(JSON.parse)
材料还给出一个常见封装思路:在 localStorage 数据里增加 expiryTime,读取时判断过期并返回 null。
// localStorage 过期时间封装(示意)
const storage = {
  setStorage(key, value, durationMs) {
    const data = {
      value,
      // durationMs 不传或非法:不设置过期时间
      expiryTime: !durationMs || isNaN(durationMs) ? 0 : Date.now() + parseInt(durationMs, 10),
    }
    localStorage.setItem(key, JSON.stringify(data))
  },

  getStorage(key) {
    const raw = localStorage.getItem(key)
    if (!raw || raw === 'null') return null

    let obj
    try {
      obj = JSON.parse(raw)
    } catch {
      return null
    }

    if (obj.expiryTime === 0 || obj.expiryTime > Date.now()) return obj.value
    return null
  },

  removeStorage(key) {
    localStorage.removeItem(key)
  },
}
IndexedDB:大容量与结构化数据
IndexedDB 是浏览器端的 NoSQL 存储系统,材料强调:
- 可存储多种数据类型(包括二进制)
- 容量相对更大(材料提到不少于 250M)
- 需要兼容性权衡,遵循渐进增强
材料展示了基本流程:
- 检测支持
open打开数据库与版本onupgradeneeded创建对象仓库(objectStore)- 使用事务做新增/读取(示意用
id作为主键)
同时也建议使用封装库(如 idb)来简化原生 API 复杂度。
import { openDB } from 'idb'

const dbPromise = openDB('juejin', 1, {
  upgrade(db) {
    db.createObjectStore('store', { keyPath: 'id' })
  },
})

// 新增
export async function add(val) {
  return (await dbPromise).add('store', val)
}

// 读取
export async function get(key) {
  return (await dbPromise).get('store', key)
}
Nginx 配缓存头:工程落地关键
缓存相关配置常常不止在后端代码里,也会在 Nginx(或静态资源服务)中完成。
材料里先讲跨域排查,再讲缓存头配置。
跨域排查:先看 CORS
常见要点:
- 检查
Access-Control-Allow-Origin是否包含前端域名白名单 - 前端如果开启
axios.defaults.withCredentials = true:- 服务器端
Access-Control-Allow-Origin不能是* - 需要设置
access-control-allow-credentials: true
- 服务器端
- 触发预检(OPTIONS)时,还可能需要配置:
access-control-allow-methodsaccess-control-allow-headers
Nginx 配缓存:HTML 协商 + 静态强缓存
材料给出两个典型配置片段:
- 对
html/htm禁用强缓存,走协商校验(示例里用Cache-Control: no-cache) - 对
js/css/img设置较长expires(示例里用expires 1d;)
并提醒一个常见坑:add_header 的继承行为可能受 if 模块层级影响,导致你以为写了却没生效,改完需要用 DevTools 验证响应头是否符合预期。
调试与验证:Chrome DevTools Application 面板
缓存正确与否最终要靠验证。材料强调 Application 面板覆盖了浏览器存储型缓存的大多数调试入口。
重点包括:
Clear site data:可按类型清空 Service Workers、Local/Session Storage、IndexedDB 等- Cookie / Web Storage:
- 可查看、删除和新增
- 注意
HttpOnly的 Cookie 不能被 JS 获取与修改
- IndexedDB:
- 可查看与删除(材料提到 Application 面板中不支持直接新增修改)
- PWA:
Manifest可以在 Application 面板中查看
- Service Worker 调试:
- Service Workers 菜单可测试离线、强制更新、绕过缓存从网络获取
Cache Storage可查看缓存内容并删除、搜索Background Services可查看 Push/Sync/Periodic Sync 等相关记录
结语:真正要练的是“推断能力”
前端缓存不是记一堆首部字段就结束了。它更像一条链路:
- HTTP 缓存告诉你“资源是否应该复用”
- 浏览器缓存告诉你“复用在哪一层、读得快不快”
- Service Worker 和存储型缓存则把控制权交给前端,让你可以离线与维持登录态
当你理解了强缓存的新鲜度推算、协商缓存的标识校验、以及浏览器缓存的命中顺序,你遇到缓存相关问题就能从现象推导到原因,而不是靠猜。