AGI全栈项目
LLMOps项目架构
| --- | --- | | 表示层 | PC网站、开放API、APP | | 接入层 | Nginx、负载均衡 | | 控制层 | AI应用模块、用户模块、授权模块、插件模块 | | 服务层 | LLM应用服务、上传服务、授权服务、文本嵌入服务 | | 核心层 | 多LLM集成、Agent集成、LangChain封装 | | 存储层 | PostgreSQL、Redis、向量数据库、对象存储 | | 资源层 | Linux服务器、Docker虚拟机、K8s集群 |
技术栈
- 使用 Python 作为后端编程语言虽然性能比不上Java等编译型等语言,但是Python丰富的生态系统,庞大的AI开源模型、机器学习基础库等,是其他语言无法媲美的。
- Flask是一个轻量级的框架,核心非常小,功能丰富但不臃肿,性能对比Django强了不少,零基础也可以快速入门,大大降低了学习难度。
- 对于LLM应用开发,可以使用LangChain极大简化开发流程,提升开发效率,其他语言需要自己封装轮子。
- 使用 Postgres 数据库
- PyTest 单元测试
环境搭建
后端搭建
- Python虚拟环境的创建与优缺点
- 创建虚拟环境:
python -m venv <环境名>,该命令在Python 2.7+/Python3.3+以上版本可用 - python 虚拟环境与系统环境之间是隔离的,不会相互干扰,不会对系统环境造成任何影响,最大程度避免包冲突
- 占用更大的空间
- 激活虚拟环境:
activate(cmdenv\Scripts\activate) - 退出虚拟环境:
deactivate(cmdenv\Scripts\deactivate.bat)
- 激活虚拟环境:
- 腾讯云pip镜像加速装置
- 临时使用:
pip install -i <镜像地址> <包名> - 永久使用:
pip config set global.index-url <镜像地址> - 镜像地址:https://mirrors.cloud.tencent.com/pypi/simple
- 查询镜像源:
pip config list
- python 新建代码模版
#! /usr/bin/env python
# -*- coding: utf-8 -*-
"""
@Time    : ${DATE} ${TIME}
@Author  : liuhuakawaii@gmail.com
@File    : ${NAME}.py
"""- 插件推荐
- .env files
- CodeGlance Pro
项目目录结构约定、规范与依赖注入
Flask是一个优美的微框架,这即是一件好事--你可以按照自己的习惯和想法来组织你的项目,不过对于团队来说这可能是一件坏事--团队每个人都有自己的喜好,这会使整体项目的结构很混乱。因此我们为LLMOp项目设计提炼了一种规范,它不仅仅是结构,风格还还有诸多细节
- 项目结构 对于很多人来说,适应规范会觉得很不舒服,但在开发中,这是一件必须的事,越规矩,越自由。
|---app  // 应用入口集合
|    ├── __init__.py
│    └── http
│---config  // 应用配置文件
│   ├── __init__.py
│   ├── config.py
│   └── default_config.py
│---internal  // 应用所有内部文件
│   └── core  // LLM核心文件,集成LangChain, LLM, Embedding等模型的代码
│       ├── agent
│       ├── chain
│       ├── prompt
│       ├── model_runtime
│       ├── moderation
│       ├── tool
│       ├── vector_store
│       └── ...
│   └──exception  // 通用公共异常目录
│       ├── __init__.py
│       ├── exception.py
│       └── ...
│   └──extension  // Flask扩展文件目录
│       ├── __init__.py
│       ├── database_extension.py
|       └── ...
|   └──handler  // 路由处理器、控制器目录
│       ├── __init__.py
│       ├── account_handler.py
│       └── ...
│   └──middleware  // 应用中间件目录,包含检验是否登录
│       ├── __init__.py
│       ├── middleware.py
|       └── ...
|   └──migration  // 数据库迁移文件目录,自动生成
│       ├── versions
|       └── ...
|   └──model  // 数据库模型文件目录
│       ├── __init__.py
│       ├── account.py
|       └── ...
|   └──router  // 应用路由文件夹
│       ├── __init__.py
│       └── router.py
│   └──schedule  // 调度任务、定时任务文件夹
│       ├── __init__.py
│       └── ...
│   └──schema  // 请求和响应的结构体
│       └── __init__.py
│   └──server  // 构建的应用,与app文件夹对应
│       └── __init__.py
│   └──service  // 服务层文件夹
│       ├── __init__.py
│       └── oauth_service.py
│   └──task  // 任务文件夹,支持即时任务+延迟任务
│       └── __init__.py
│---pkg  // 扩展包文件夹
│   ├── __init__.py
│   └── oauth
│       ├── __init__.py
│       └── github_oauth.py
|---storage  // 本地存储文件夹
|---test  // 测试目录(注意在settings里面排除)
|---venv  // 虚拟环境
|---.env  // 应用配置文件
|---.gitignore  // 配置git忽略文件
|---requirements.txt  // 第三方包依赖管理
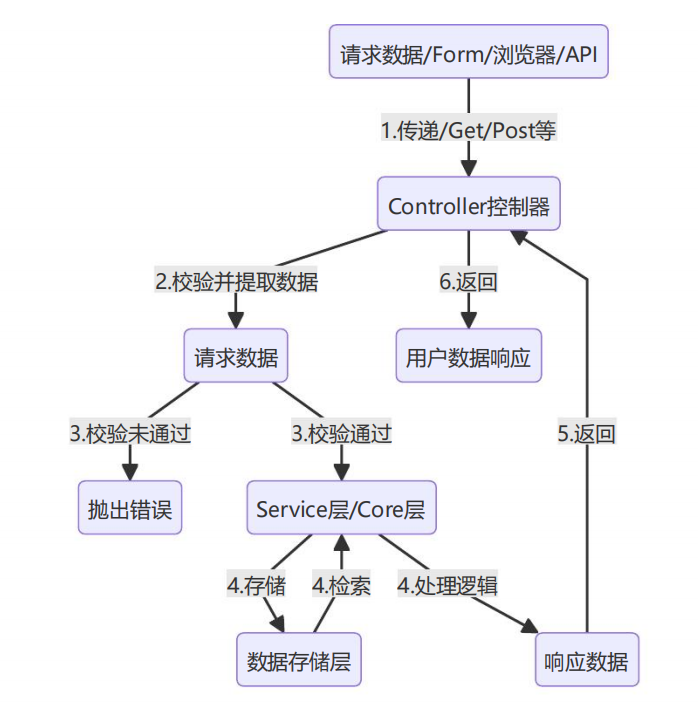
|---README.md // 项目说明文件- 代码运行流程图
- 文件与Python类函数命名规范 3.1文件名
- 使用全部小写字母。
- 使用下划线分隔单词,例如:
app_service.py。 - 尽可能保证文件作用的单一,不要把所有代码一次性写在同一个文件中。 3.2类名
- 使用驼峰命名法,例如:
class AppService。 - 类名应该以大写字母开头,每个单词的首字母都大写。
- 如果类名由多个单词组成,单词之间不使用下划线分割。 3.3函数名和方法
- 使用小写字母。
- 使用下划线分隔单词。
- 例如:
get_account,generate_token等。 3.4变量名 - 使用小写字母。
- 使用下划线分隔单词。
- 例如:
my_variable,token_count。 3.5常量 - 使用全大写字母。
- 使用下划线分隔单词。
- 例如:
MAX SIZE,PI等。 3.6私有变量与方法 - 以一个下划线开头表示私有,例如:
my_private_variable,_my_private_method()等 - 在Python中并没有严格的私有变量/方法,这种命名约定只是一种约定,而不是强制规则,实际上这些变量/方法仍然可以被使用,但是作为一种约定,在外部调用时,不应该调用私有的变量与方法。 3.7模块名
- 与文件名类似,使用全部小写字母,使用下划线分隔单词。
- 例如:
my_module.py对应的模块名应该是my_module。 - 模块下创建
_init_.py文件代表当前目录为一个模块,并尽可能在_init_.py中使用__all__简化导出。
- Python中的依赖注入
- 依赖注入是软件工程中的一种设计模式,它允许在创建对象时由夕下部提供依赖关系,而不是自己创建这些依赖关系。
- 简单来说,即我需要什么,传递什么,而不是自己内部构建,
Corntroller需要使用Service的内容,将Service作为参数传递给Controller即可,在Python中可以使用injector包来快速实现依赖注 - 安装:
pip install injector - 使用示例:
from injector import Injector, inject


class A:
    name: str = 'llmops'


@inject
class B:
    def __init__(self, a: A):
        self.a = a

    def print(self):
        print(f"Class A的name:{self.a.name}")


injector = Injector()
b = injector.get(B)
b.print()
其中@inject装饰器用于注入,使用@inject装饰的函数/类,不需要显式创建依赖对象就可以直接使用。要获取被注入的对象,可以使用Injector实例的get0方法传入特定的类型,即可获取。 5. 获取requirements.txt
- 运行
pip freeze > requirements.txt命令即可。 - 使用
pipreqs --ignore env --force命令
pip install --no-deps pipreqs
pip install yarg==0.1.9 docopt==0.6.2- 安装依赖:
pip install -r requirements.txt
PostgresSQL pgAdmin4连接密码问题
- 修改 pg_hba.conf:
host    all             all             127.0.0.1/32            trust
host all all ::1/128 trust- 重启 PostgreSQL 服务:
# Linux / macOS
sudo systemctl restart postgresql

# Windows
net stop postgresql-x64-17
net start postgresql-x64-17- windows 下关闭 PostgreSQL 自动启动.
win+r services.msc
30行代码实现一个聊天机器人接口
- 安装 openai:
pip install --upgrade openai - 核心代码部分:
from flask import request
from openai import OpenAI


class AppHandler:
    """应用控制器"""

    def completion(self):
        """聊天接口"""
        # 1.提取从接口中获取的输入
        query = request.json.get("query")
        # 2.构建OpenAI客户端,并发起请求
        client = OpenAI(
            api_key="<your api key>",
            base_url="https://api.moonshot.cn/v1",
        )
        # 3.得到请求响应,然后将OpenAI的响应传递给前端
        completion = client.chat.completions.create(
            model="kimi-k2-0905-preview",
            messages=[
                {"role": "system",
                 "content": "你是 Kimi,由 Moonshot AI 提供的人工智能助手,你更擅长中文和英文的对话。你会为用户提供安全,有帮助,准确的回答。同时,你会拒绝一切涉及恐怖主义,种族歧视,黄色暴力等问题的回答。Moonshot AI 为专有名词,不可翻译成其他语言。"},
                {"role": "user", "content": query}
            ],
            temperature=0.6,
        )
        # 通过 API 我们获得了 Kimi 大模型给予我们的回复消息(role=assistant)
        content = completion.choices[0].message.content
return content- 将.env加载到环境变量实现配置分离
- 在Python项目中,如果想将.env文件的信息加载成环境变量,可以使用python-dotenv库。
pip install python-dotenv - openai默认读取的是
apikey from OPENAI_API_KEY,organization from OPENAI_ORG_ID,如果你的命名不一致则可以通过os.getenv('<youkey>')来获取在环境变量中的配置信息,将代码与配置分离,方便后期维护。
- 使用
Flask-wtf对数据进行验证
pip install -U Flask-WTF
统一响应接口设计与实现
HTTP响应状态码,无论是成功还是失败,全部设置为200,通过业务状态码来判断操作是否成功,减少前端的判断。发生错误时,需要在message和data中携带相应的错误与描述信息
- 定义接口统一响应格式
{
  "code":"success",//响应状态
  "message":"获取AI应用数据成功",//业务消息提示
  "data":{}//业务获取的数据
}为了简化开发,我们将将业务状态码定义成success、fail、not_found、unauthorized、forbidden、validate_error. message为相应的接口描述,如果业务状态码为非成功状态,需需要添加上相应的描述信息。 2. 接口分页数据响应格式 如果返回的数据为列表型分页数据,则在data中存在两个字段paginator和list,分别代表分页的数据信息,响应的数据列表信息,数据格式如下所示:
{
  "code": "success",
  "message":"",
  "data":{
    "paginator":{
      "pagesize":10,//当前页数每页条数
      "current_page":1, //当前页数
      "total_page":10,//总页数
      "total_record":100//总记录条数
    },
    "list":[],//分页的列表数据
  }
}
使用pytest进行单元测试
在Pytest中,测试用例的编写需要遵循以下规则:
- 测试文件以
test_开头或_test结尾; - 测试类以
Test开头,并且不能带有init方法; - 测试函数以
test_开头; - 断言使用基本的
assert即可; pytest会递归查找当前目录及子目录下的所有以test_开始或者_test结尾的Python脚本,执行其中符合规则的函数和方法,不需要显示调用,一些常见的运行命令:
#直接运行文件夹内符合规则的所有用例
pytest folder_name
#执行某个Python文件中的用例
pytest test_file.py
#执行某个Python文件内的某个函数
pytest test_file.py::test_func
#执行某个Python文件内某个测试类的某个方法
pytest test_file.py::TestClass::test_method
#运行测试时显示标准输出(stdout),允许测试中的print()语句直接输出到终端
pytest -s
#运行测试时显示详细的信息,包括每个测试用例的名称及结果(试通过/失败/跳过等),-v代表verbose
pytest -v
应用ORM模型的创建与增删改查
- 创建模型 要想在项目中使用ORM,必须创建对应的类,并继承
db.Model,即可实现与对应数据库进行关联。在类中还可以通过_tablename_属性来设置 表名,通过_table_args来为表添加相应的主键index索引、unique索引等约束。其中关于ORM模型的字段类型、索引约束、主键等均可以从sqlalchemy包中导入,从这个包导入的类支持所有的数据库,在切换数据库时不需要进行调整,除此之外怀还可以导入特定数据库特有的结构,例如Postgres中特有的JSONB数据类型,特有的类型在切换数据库时,需要修改代码进行调整。 一些常见的sqlalchemy的数据类型:
from sqlalchemy import(
  Column,#用户定义字段
  UUID, #UUID类型,例如:123e4567-e89b-12d3-a456-426655440000
  String,#字符串,对应数据库的varchar
  Text,#长文本类型,对应数据库的text
  DateTime,#事件类型,对应数据库的timestamp
  Integer,#整形,对应数据库的int
  Decimal,#小数型,对应数据库的decimal
  PrimaryKeyConstraint,#创建主键约束
  Index,#创建索引
  UniqueConstraint,#创建唯一值约束
)
from sqlalchemy.dialects.postgresql import JSONB #postgres 特有的jsonb数据,使用二进制存储json,性能更强