从 8.6GB 到 Draco Worker:一次 Rodin 3D 预览内存暴涨排查复盘
本文记录一次真实的前端 3D 内存问题排查过程。场景是 Rodin 任务卡片中反复打开、加载 3D 模型、关闭,再手动 GC 后,Chrome Tab 内存仍持续升高,最高曾到数 GB,页面逐渐卡顿。
这次排查的关键不是“猜哪里没释放”,而是不断把现象拆成可验证的证据:Heap Snapshot、运行时日志、Chrome Task Manager、Network Initiator、Worker 生命周期,最后定位到 Three.js 资源释放和 Draco 解码 worker 泄漏两个层面的问题。
1. 问题现象
最初的复现路径很简单:
- 页面加载成功。
- 打开一个 card,加载 Rodin 3D 模型。
- 关闭 card。
- 在 DevTools Memory 面板手动 GC。
- 多次重复打开、关闭 card。
从浏览器外部观察,Chrome Tab 内存不断升高,最高到过 8GB 以上。与此同时,页面开始明显卡顿。
第一反应很容易是:“是不是 Three.js 场景没释放?”但这里不能直接下结论,因为 Chrome Task Manager 里的“内存占用”并不等同于 JS Heap。它可能包括:
- JS heap。
- ArrayBuffer / TypedArray。
- WebGL native resources。
- Worker 进程或线程相关内存。
- 图片解码、网络缓存、Chrome allocator 尚未归还给 OS 的内存。
所以排查目标先拆成两件事:
- 是否存在 JS/Three 对象引用链,导致模型对象无法 GC。
- 如果 JS heap 已经下降,Tab 总内存仍高,是否有 native / worker / GPU 侧资源未释放。
2. 第一阶段:Heap Snapshot 证明模型数据确实被保留
早期 heap snapshot 的保留路径指向了一个非常典型的 Three.js 资源链:
JSArrayBufferData
  -> ArrayBuffer
  -> Float32Array / Uint32Array
  -> BufferAttribute.array
  -> BufferGeometry
  -> Mesh.geometry
  -> Group.children
  -> HomeScene._model
  -> Viewer._scene.children
这个路径说明:
- 大块 TypedArray 没有释放。
- TypedArray 被 BufferAttribute 持有。
- BufferAttribute 又被 BufferGeometry 持有。
- BufferGeometry 仍挂在 Mesh / Group / Scene 上。
- 最终模型还被
HomeScene._model和Viewer.scene.children引用。
这一步非常重要。它说明当时的内存增长里,至少有一部分不是 Chrome 统计噪声,而是真实的 JS 可达对象。
同时日志也证明了一个容易踩坑的点:仅调用 geometry.dispose() 不等于 TypedArray 立刻不可达。geometry.dispose() 释放的是 WebGL 侧资源,BufferAttribute.array 仍然是 JS 对象,如果还有引用链,它不会被 GC。
因此第一轮修复目标是:不仅 dispose Three resource,还要打断 JS 引用链。
3. 增加可下载的内存 Probe
控制台日志有两个问题:
- 高频日志很容易丢。
- Chrome Console 导出的日志不完整。
所以我们加了一个专门的 probe:window.rodinTabMemoryProbe。
典型使用方式:
rodinTabMemoryProbe.enable({
  includeUserAgentSpecificMemory: true,
  trackWorkers: true,
  sampleIntervalMs: 1000
});
rodinTabMemoryProbe.clear();
location.reload();
复现结束并手动 GC 后下载:
rodinTabMemoryProbe.mark('after-manual-gc');
setTimeout(() => rodinTabMemoryProbe.download(), 1500);
这个 probe 记录:
performance.memory中的 JS heap。- 当前 viewer / scene 的资源统计。
renderer.info.memory。- canvas 是否还在 DOM 中。
- WebGL context 是否 lost。
- 当前是否还有自定义 render callback。
- Worker 创建和 terminate 记录。
- 当前 active blob worker URL。
这一步把问题从“感觉内存没降”变成了可对比的结构化数据。
4. 第一轮修复:释放 Three 对象和 JS TypedArray
新增 disposeObject3DResources,核心做几件事:
- 遍历 Object3D tree。
- dispose geometry。
- dispose material。
- dispose material 上的 texture。
- 清理
BufferAttribute.array和 interleaved buffer 的 array。 - 清理 userData 中常见的大对象引用。
示意代码:
disposeObject3DResources(model, {
  clearAttributeArrays: true,
});
这类释放不是为了“看起来彻底”,而是针对 heap snapshot 的保留链精确打断:
BufferAttribute.array -> TypedArray -> JSArrayBufferData对应改动集中在:
src/rodinrender/utils/disposeThreeResources.tssrc/rodinrender/scenes/HomeScene.tssrc/rodinrender/widgets/Canvas.tsx
5. 第二轮修复:调整 Canvas cleanup 顺序
早期 cleanup 顺序里,SceneManager.clear() 调用太晚。结果是:
- React unmount 了 Canvas。
- 但
HomeScene仍可能持有_model。 - viewer 的 render callback 仍可能存在。
- late async load 还有机会把模型重新塞回来。
调整后的 cleanup 思路:
- 先
SceneManager.clear(),触发 active scene 的onExit()。 - 停止 loading listener 和 state manager。
- 清理 AssetManager cache。
- 清空 viewer render callback。
- 深度 dispose scene。
- dispose loaders。
renderer.renderLists.dispose()。renderer.dispose()。forceContextLoss()和WEBGL_lose_context.loseContext()。viewer.destroy()。- 移除 canvas DOM 引用。
关键日志点:
Canvas.cleanup:start
HomeScene.onExit:disposeModel
AssetManager.clear:end
Canvas.cleanup:afterDeepDispose
Canvas.cleanup:afterLoaderDispose
Canvas.cleanup:afterRendererDispose
Canvas.cleanup:end
这一轮之后,probe 里可以看到一个重要变化:
scene.totalBufferMB = 0
sceneChildren = 0
canvasConnected = false
contextLost = true
hasCustomRenderCallback = false
这说明旧的 HomeScene._model -> Viewer.scene.children -> BufferGeometry 保留链已经基本被切断。
6. 第三轮修复:处理 stale asset load
快速切换模型或快速关闭 card 时,资源加载 Promise 可能在 cleanup 之后才 resolve。这个时候如果没有保护,late resolved asset 可能重新进入 cache 或 scene。
所以 AssetManager 加了 cacheEpoch:
const loadEpoch = AssetManager.cacheEpoch;

return viewer.loadAsset(props).then((asset) => {
  if (loadEpoch !== AssetManager.cacheEpoch) {
    AssetManager.disposeLoadedAsset(asset);
    return asset;
  }

  AssetManager.resource.set(key, asset);
  return asset;
});
当 AssetManager.clear() 调用时:
AssetManager.cacheEpoch += 1;
AssetManager.resource.clear();
这样 late resolved asset 会进入 AssetManager.loadAsset:skipStaleStore 分支,被立即 dispose,而不是重新写回 cache。
这一步解决的是异步竞态,不是常规同步释放。
7. 新现象:JS Heap 降了,但 Tab 总内存仍高
经过前几轮后,JS heap 和 scene buffer 已经明显改善,但 Chrome Task Manager 仍显示 Tab 内存很高。
这时用户提供了 Chrome Task Manager 截图:
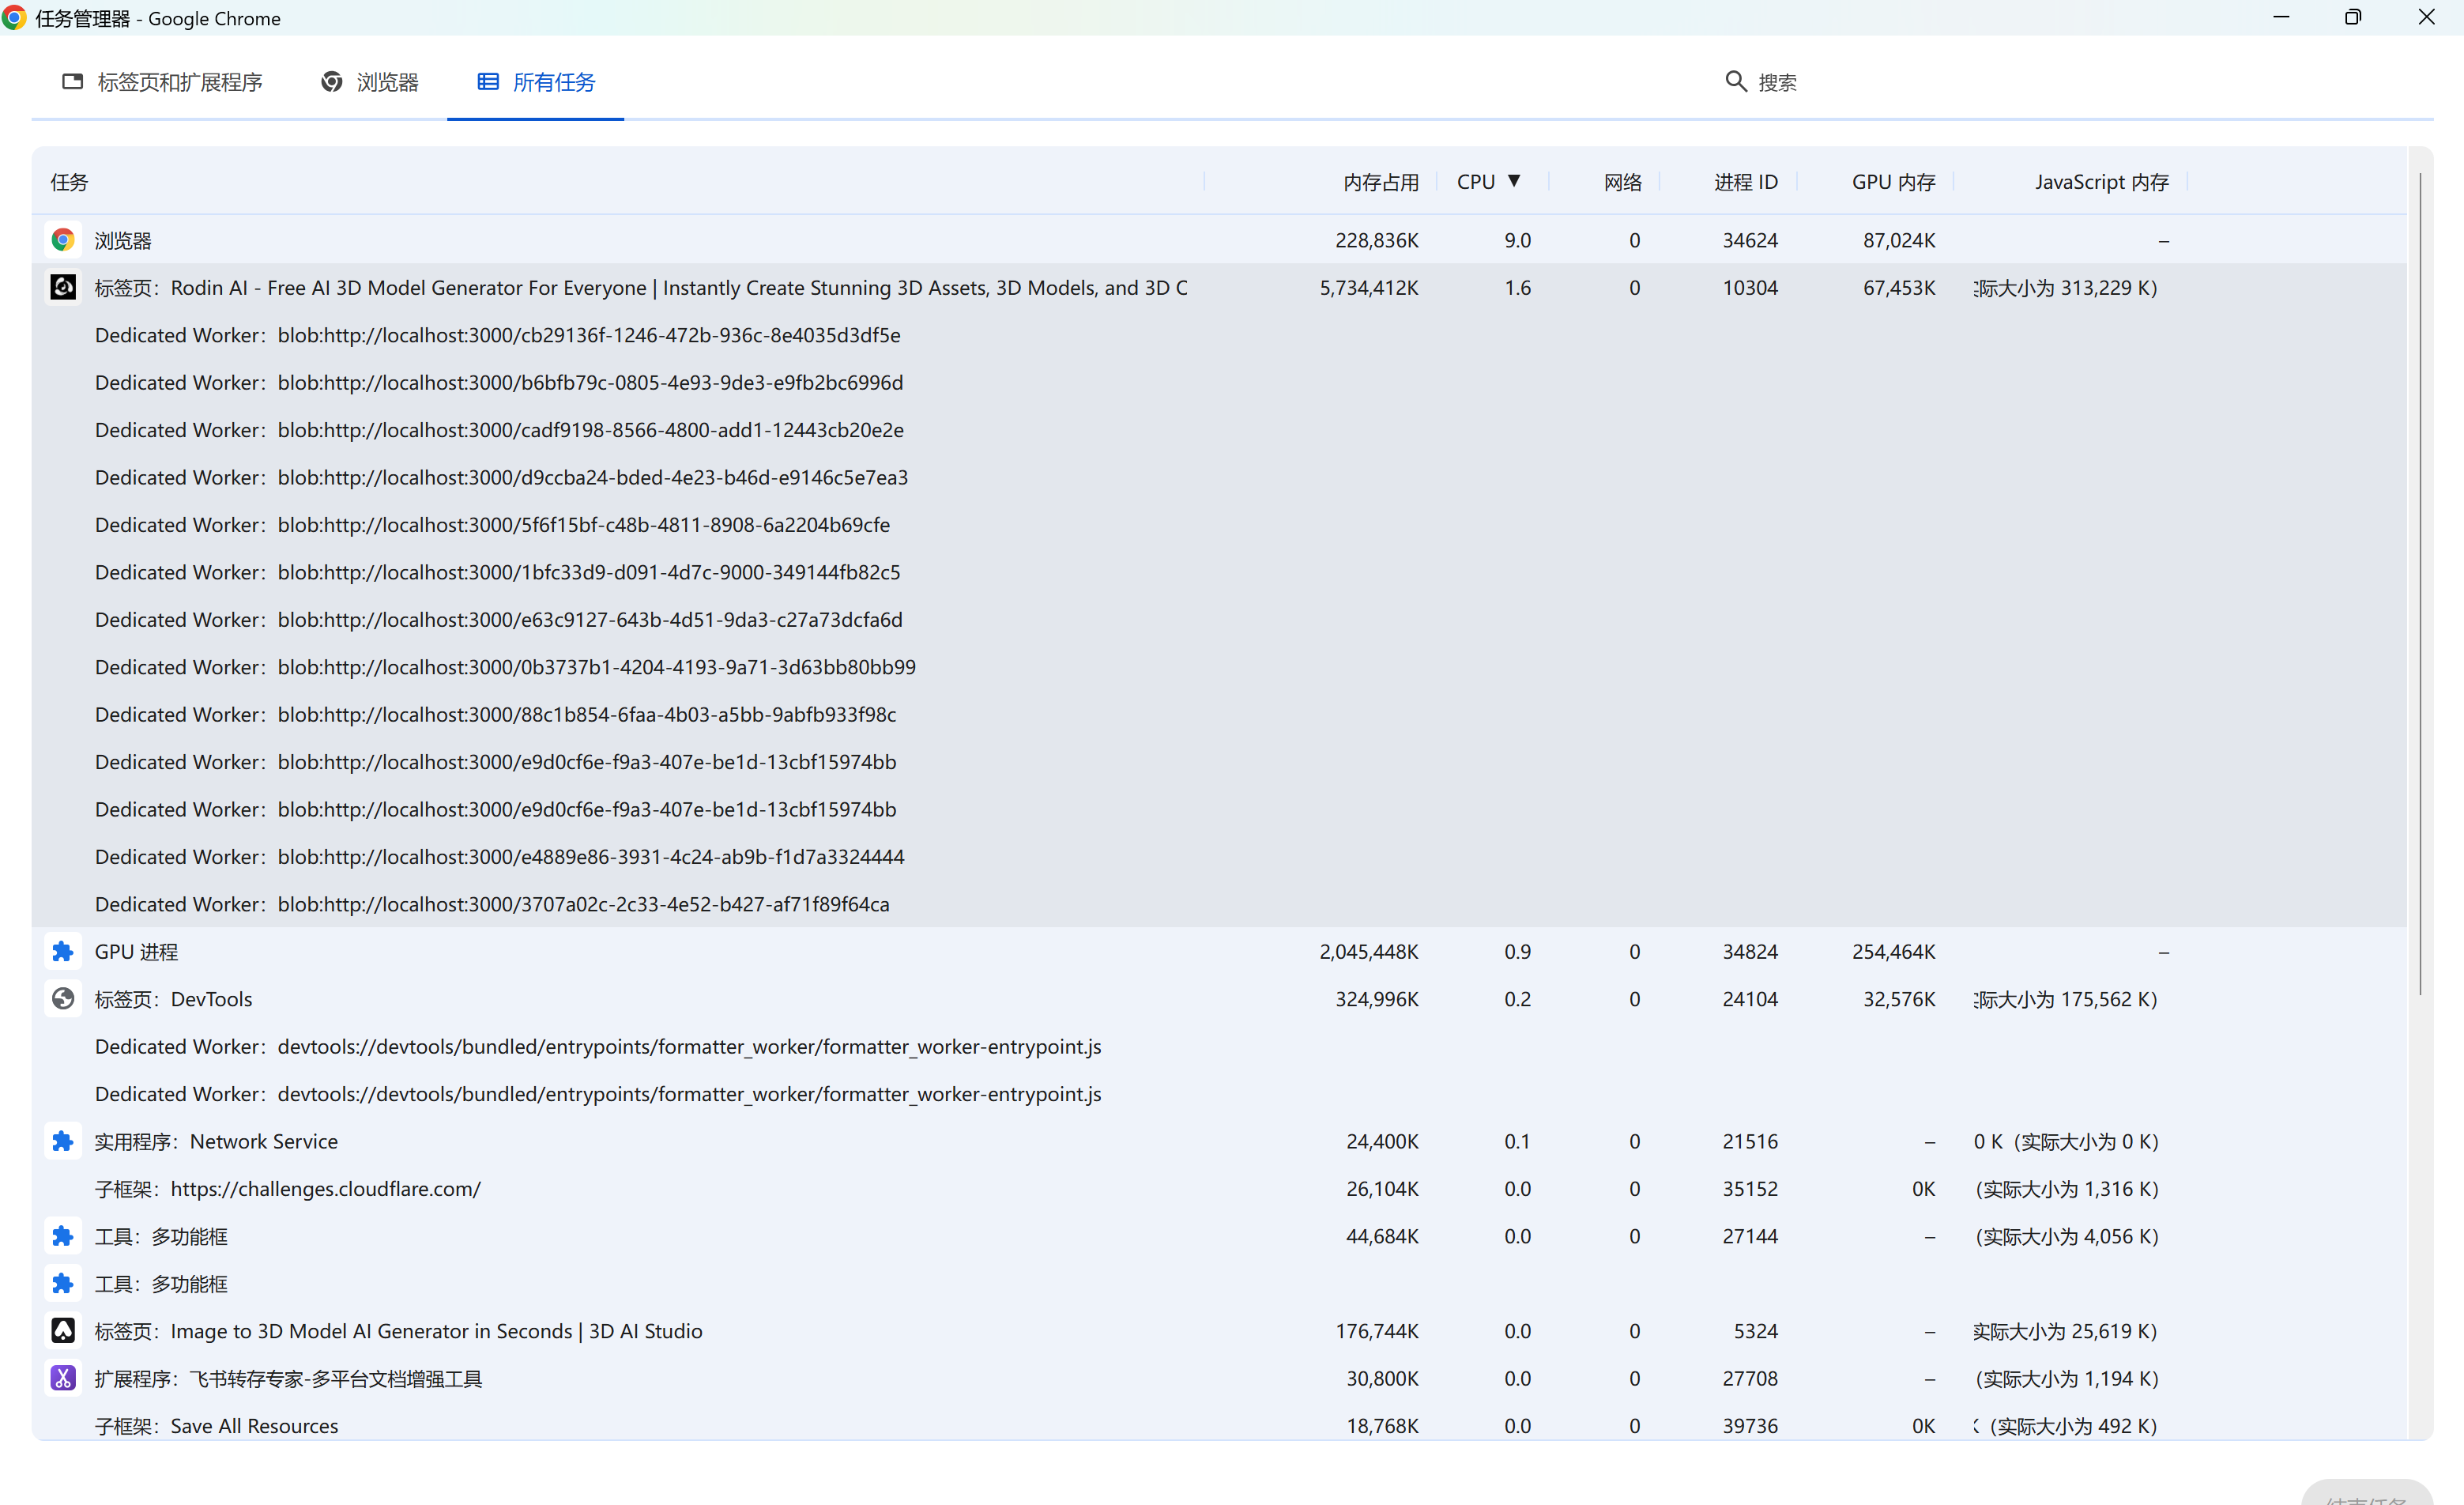
这张图里有几个关键信息:
- 页面内存占用约 5.7GB。
- 页面 JavaScript 内存实际只有约 313MB。
- 页面 GPU 内存只有几十 MB。
- 页面下面挂了大量
Dedicated Worker: blob:http://localhost:3000/...。
这说明剩余的大头不在普通 JS heap,也不主要在页面 GPU memory,而更像 worker / native 侧资源。
此时排查方向从 “Three Object3D 是否释放” 转向 “Dedicated Worker 是否泄漏”。
8. 定位 Draco Worker 泄漏
Three.js 的 DRACOLoader 会创建 Worker 来做 Draco 解码。源码行为大致是:
const worker = new Worker(this.workerSourceURL);
this.workerPool.push(worker);
而释放 worker 的入口是:
dracoLoader.dispose();它会:
- terminate workerPool 中的 worker。
- revoke workerSourceURL。
问题在于项目里的自定义 loader:
bDRCLoaderbGLTFLoaderaBINLoader
内部都持有 DRACOLoader,但最初没有暴露 dispose()。
同时 @xviewer.js/core 的 ResourceManager.destroy() 只是:
this._loaders.clear();它并不会主动调用 loader 的 dispose()。所以即使 viewer destroy 了,loader map 被清空了,Draco worker 仍可能继续活着。
第一轮 worker 修复是给三个自定义 loader 加 dispose():
dispose() {
  disposeDracoLoader(this._dracoLoader);
  this._loader = undefined;
  this._dracoLoader = undefined;
}
并在 Canvas cleanup 里补一层:
const loaderDisposeStats = disposeViewerLoaders(viewer);
recordRodinTabMemory(
  'Canvas.cleanup:afterLoaderDispose',
  () => ({ loaderDisposeStats }),
  viewer
);
这一轮后,Chrome Task Manager 明显改善,从大量 worker 变成只剩少量 worker:
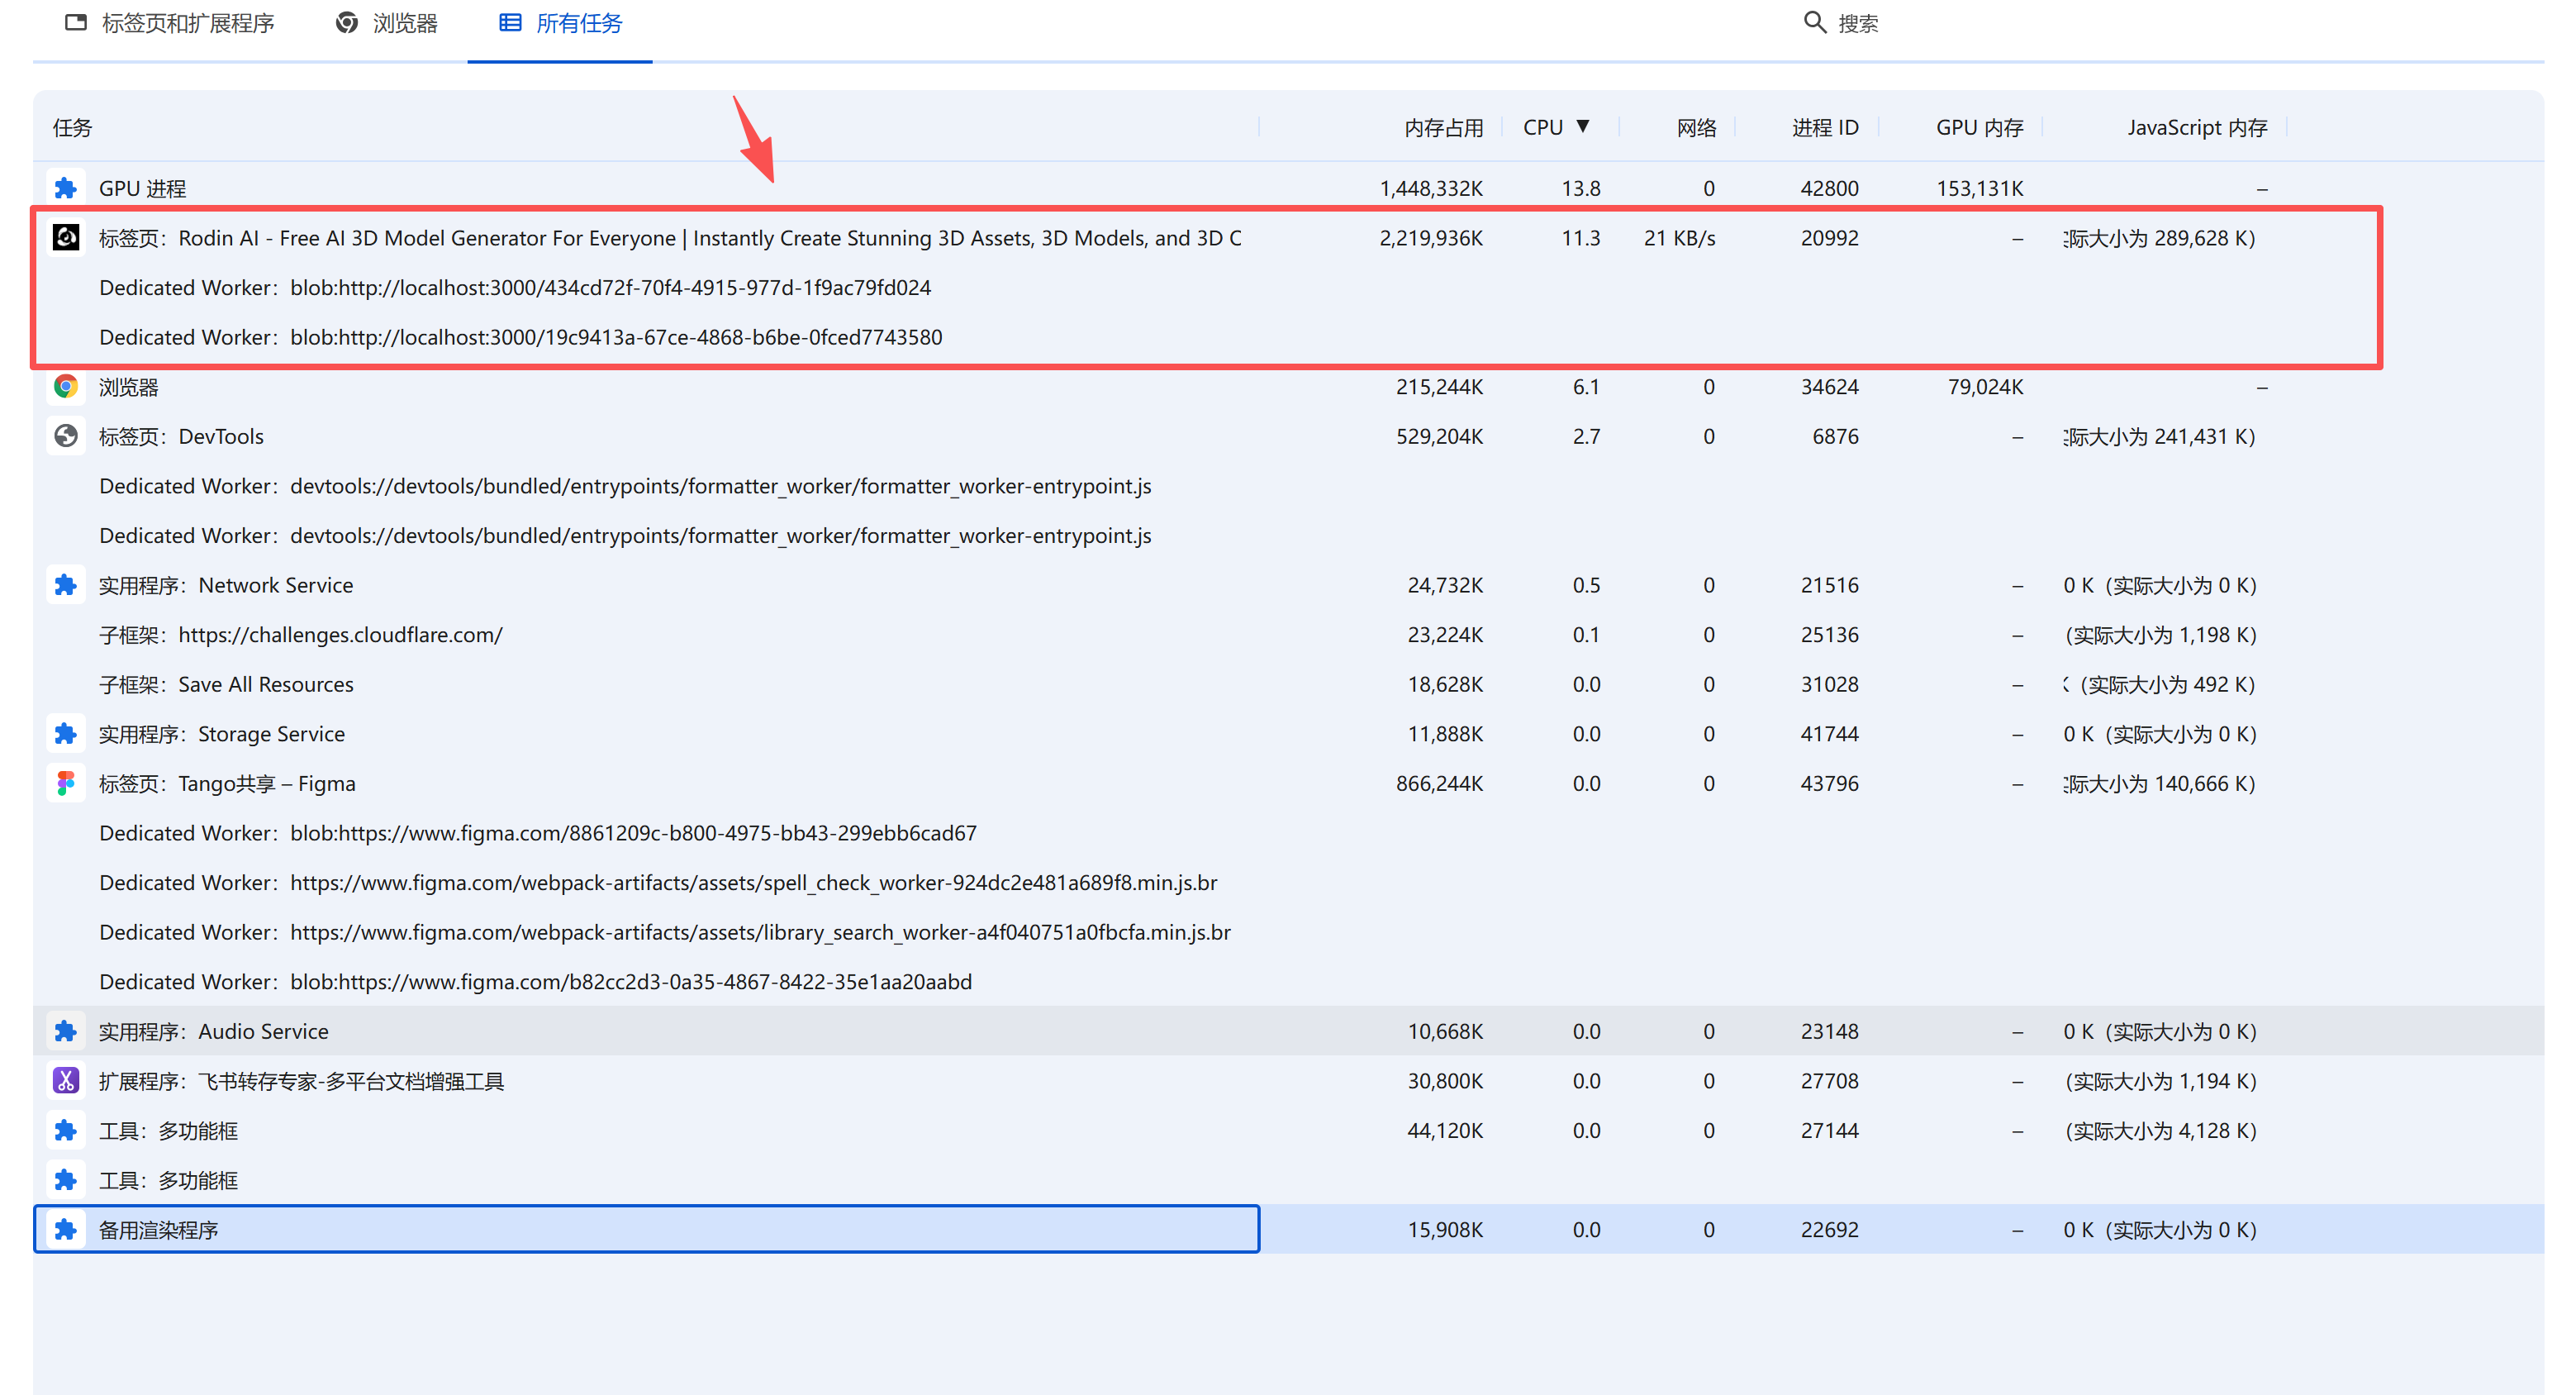
这说明主 worker 泄漏已经被修掉,但还不是全部。
9. 残留 worker:60dd91
之后又发现一个残留 worker:
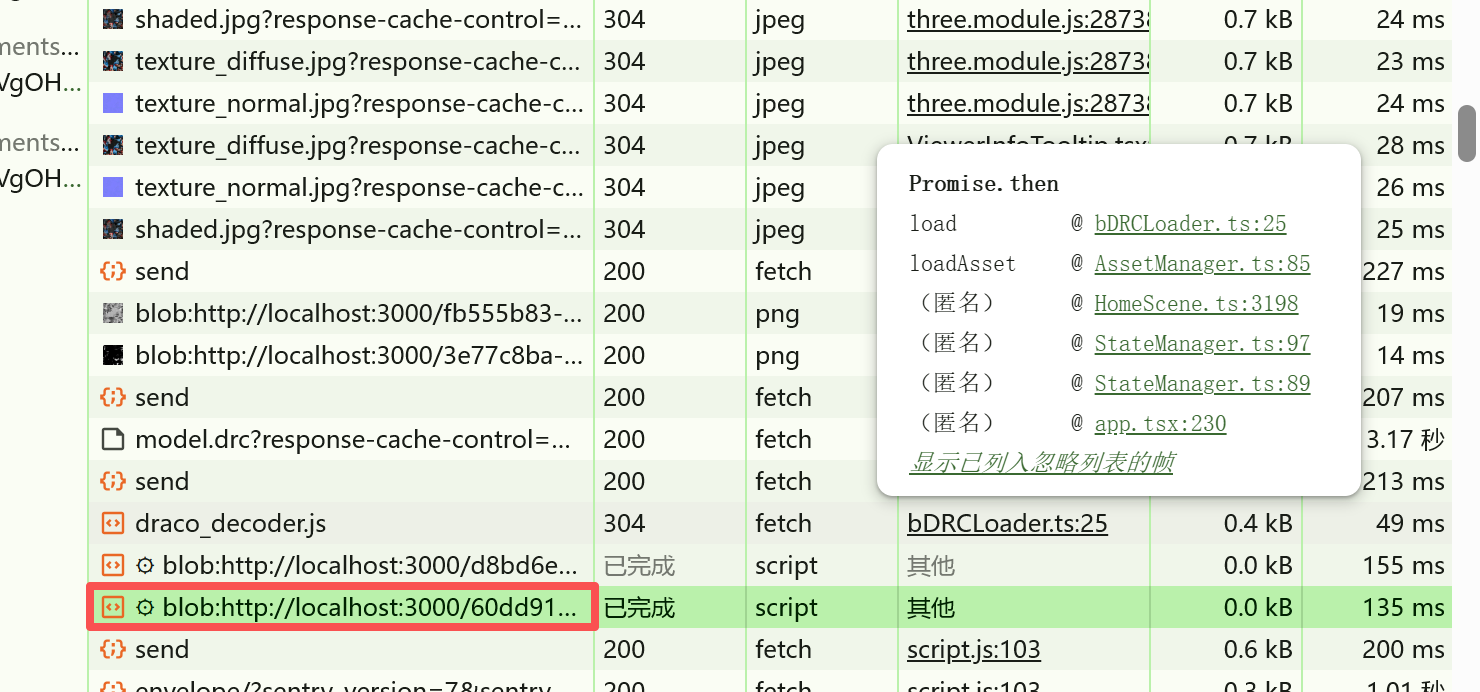
Chrome Task Manager 里同样能看到它:

对应日志证明它不是 GC 延迟:
Canvas.cleanup:start
activeBlobWorkers = 2
urls = d8bd6e..., 60dd91...

Canvas.cleanup:afterLoaderDispose
activeBlobWorkers = 1
urls = 60dd91...

after-manual-gc
activeBlobWorkers = 1
urls = 60dd91...
这说明:
- cleanup 确实杀掉了一个 worker。
60dd91...没有被当前 dispose 链覆盖。- 手动 GC 后它仍 active,所以不是 GC 时机问题。
进一步看 Network Initiator,调用栈指向:
bDRCLoader.ts:25
AssetManager.ts:85
HomeScene.ts:3198
所以它属于 Rodin 模型加载链路中的 Draco 解码 worker。
当时的修复策略是新增 disposeDracoLoader,对 Draco loader 做更强的释放:
- 立即 dispose。
- 如果
decoderPending还没完成,在 Promise settle 后再 dispose 一次。 - 记录已知 worker。
- dispose 后禁止
_getWorker再创建 worker。
这是为了覆盖 DRACOLoader 的一个竞态:如果 decoder 初始化还没完成,dispose() 时 workerPool 可能还是空;之后 _initDecoder().then(...) 仍可能继续创建 worker。
10. 残留 worker:c1a66,快速切换触发的 stale load
最后一份日志里又出现:
blob:http://localhost:3000/c1a66c36-c957-4355-beb3-9aa33c541f6c关键时序:
seq42 HomeScene.ModelAssets:skipStale
activeBlobWorkers = 3
urls = 4cc037de..., c1a66..., 4cc037de...

seq50 Canvas.cleanup:afterLoaderDispose
activeBlobWorkers = 1
urls = c1a66...

seq66 after-manual-gc
activeBlobWorkers = 1
urls = c1a66...
这个时序说明:
skipStale证明快速切换模型确实触发了过期加载。4cc037de...出现两次,说明某个 Draco loader pool 同时创建了多个 worker。- cleanup 能杀掉
4cc037de...相关 worker。 - 但
c1a66...属于另一个未被当前 tracked loader 集合覆盖的 Draco loader 实例。
所以更准确的结论不是:
快速切换导致 worker 来不及 GC而是:
快速切换触发 stale 异步模型加载;
该 stale load 创建了另一个 Draco worker;
这个 worker 来自未纳入统一登记的 DRACOLoader 实例;
所以常规 loader dispose 没有覆盖它。
为了解决这个盲区,最终把追踪从“我们创建的 Draco loader 实例”升级为“全局 patch DRACOLoader.prototype._getWorker”。
核心思想:
const originalGetWorker = DRACOLoader.prototype._getWorker;

DRACOLoader.prototype._getWorker = function (...args) {
  const state = ensureManagedDracoState(this);

  if (state.disposed) {
    return Promise.reject(new Error('DRACOLoader has been disposed.'));
  }

  return originalGetWorker.apply(this, args).then((worker) => {
    state.workers.add(worker);

    if (state.disposed) {
      worker.terminate();
      throw new Error('DRACOLoader has been disposed.');
    }

    return worker;
  });
};
这样不管 worker 来自哪里,只要它通过 Three.js DRACOLoader 创建,就会进入统一登记表:
bDRCLoaderbGLTFLoaderaBINLoader@xviewer.js/core默认aGLTFLoader- 其他直接
new DRACOLoader()的路径
cleanup 时统一调用:
disposeTrackedDracoLoaders();这一步是最后一轮补丁,已经通过构建,但仍需要下一份用户实际复现日志确认:
after-manual-gc.workerStats.activeBlobWorkers === 011. 代码改动总览
11.1 Three 资源深度释放
文件:
src/rodinrender/utils/disposeThreeResources.ts解决:
BufferGeometry.dispose()不清 JS TypedArray 的问题。- material / texture / geometry 多处引用导致重复释放或漏释放的问题。
关键点:
disposeObject3DResources(object, {
  clearAttributeArrays: true,
});
11.2 Canvas cleanup 顺序
文件:
src/rodinrender/widgets/Canvas.tsx解决:
- SceneManager 清理过晚。
- viewer render callback 未断开。
- renderer / WebGL context / canvas DOM 清理不完整。
关键阶段:
SceneManager.clear()
stateManager.destroy()
clearRes()
disposeObject3DResources(viewer.scene)
disposeViewerLoaders(viewer)
renderer.renderLists.dispose()
renderer.dispose()
renderer.forceContextLoss()
viewer.destroy()
canvasRef.remove()
11.3 AssetManager stale load 防护
文件:
src/rodinrender/managers/AssetManager.ts解决:
- cleanup 后异步资源 resolve,又重新写入 cache。
关键机制:
cacheEpoch
loadEpoch !== cacheEpoch -> disposeLoadedAsset(asset)
11.4 Loader dispose
文件:
src/rodinrender/loaders/aBINLoader.ts
src/rodinrender/loaders/bDRCLoader.ts
src/rodinrender/loaders/bGLTFLoader.ts
src/rodinrender/utils/disposeViewerLoaders.ts
解决:
- 自定义 loader 内部的
DRACOLoader没有被 dispose。 ResourceManager.destroy()只 clear map,不调用 dispose。
11.5 Draco Worker 全局追踪
文件:
src/rodinrender/loaders/disposeDracoLoader.ts解决:
- stale load 创建的
DRACOLoader不在当前 viewer loader map 中。 - 同一个 Draco loader pool 多 worker。
- decoder 初始化中途 dispose 的竞态。
- 第三方或默认 loader 直接创建 worker 但没有进入自定义 dispose 链。
12. 关键数据变化
| 阶段 | 主要证据 | 结论 |
|---|---|---|
| 初始 heap snapshot | HomeScene._model -> BufferGeometry -> TypedArray | 模型 JS 数据确实被保留 |
| Three cleanup 后 | scene.totalBufferMB = 0,sceneChildren = 0 | 场景对象保留链基本切断 |
| Task Manager 5.7GB | JS 内存约 313MB,但大量 blob Dedicated Worker | 剩余问题不主要在 JS heap |
| loader dispose 后 | 大量 worker 降到少量 worker | 主 Draco worker 泄漏修复有效 |
60dd91 日志 | cleanup 后仍 active,手动 GC 后仍 active | 有 loader/worker 未被 dispose 链覆盖 |
c1a66 日志 | 首次出现在 HomeScene.ModelAssets:skipStale | 快速切换触发 stale load,产生未登记 worker |
| 最终补丁 | patch DRACOLoader.prototype._getWorker | 覆盖所有 Draco worker 创建路径,待最终复测 |
最新两份可用 probe 的关键摘要:
| Probe | cleanup 次数 | after GC JS heap | after GC active blob worker | 关键残留 |
|---|---|---|---|---|
09-07-10 | 5 | 404.36 MB | 1 | 60dd91... |
09-16-55 | 4 | 405.56 MB | 1 | c1a66... |
注意:这两份日志是在最后一次全局 prototype 追踪补丁之前采集的。它们用于证明残留 worker 的根因,不代表最终补丁后的结果。
13. 验证方法
建议每轮都使用同一套复现步骤:
rodinTabMemoryProbe.enable({
  includeUserAgentSpecificMemory: true,
  trackWorkers: true,
  sampleIntervalMs: 1000
});
rodinTabMemoryProbe.clear();
location.reload();
然后快速切换模型、反复开关 card,最后手动 GC,再执行:
rodinTabMemoryProbe.mark('after-manual-gc');
setTimeout(() => rodinTabMemoryProbe.download(), 1500);
最终应该重点看:
Canvas.cleanup:afterLoaderDispose.workerStats.activeBlobWorkers
after-manual-gc.workerStats.activeBlobWorkers
期望结果:
activeBlobWorkers = 0Chrome Task Manager 中也不应继续残留:
Dedicated Worker: blob:http://localhost:3000/...14. 排查经验总结
14.1 不要只看 Chrome Tab 总内存
Tab 总内存高不等于 JS 泄漏。必须拆开看:
- JS heap 是否下降。
- scene buffer 是否归零。
- GPU memory 是否异常。
- Dedicated Worker 是否累积。
本次中后期最关键的证据就是:JS heap 已经降到约 400MB,但 Tab 仍然 1GB 到 2GB 以上,并且 Task Manager 下挂着 blob worker。
14.2 Three.js dispose 不等于 JS 引用断开
geometry.dispose() 主要释放 GPU resource,不负责帮你断开所有 JS 引用。
如果 heap snapshot 里看到:
BufferAttribute.array -> TypedArray就要检查是否仍有 model / geometry / attribute 的引用链。
14.3 Worker 泄漏要看 Worker 生命周期,不要只看 Heap
Draco worker 是 blob worker。它不一定在 JS heap 里表现为一个大对象,但会在 Chrome Task Manager 里非常明显。
因此这类问题需要:
- patch
window.Worker记录创建和 terminate。 - 在 probe 中记录 active worker URL。
- 用 Network Initiator 辅助定位创建来源。
14.4 快速切换模型一定要考虑 stale async
用户快速切换、关闭 modal、切换 task,都会制造 stale Promise。
可靠做法不是等 Promise 自己结束,而是:
- 请求有 request id。
- cache 有 epoch。
- late result 必须 dispose。
- loader / worker 必须可以在 cleanup 时统一扫尾。
14.5 第三方 ResourceManager 的 destroy 不一定真的 destroy
这次 @xviewer.js/core 的 ResourceManager.destroy() 只是清空 loader map。它并不知道 loader 内部还持有什么 native / worker 资源。
所以集成第三方库时,不能只看外层 destroy() 名字,还要看它是否调用了子资源的 dispose()。
15. 当前状态
已经验证成立的结论:
- Three 模型对象保留链存在,且已通过 deep dispose 和 cleanup 顺序修复。
- JS heap 已能在手动 GC 后回落到约 400MB。
- 大量 Dedicated Worker 是 Tab 总内存不降的主要嫌疑之一。
- 自定义 loader 没有 dispose Draco worker 是明确代码问题。
- 快速切换会触发 stale load,残留 worker 会出现在
HomeScene.ModelAssets:skipStale附近。
已经实现但需要下一轮实际复测确认的结论:
- 全局 patch
DRACOLoader.prototype._getWorker后,60dd91.../c1a66...这类未登记 worker 应被统一清理。 - 最终目标是
after-manual-gc.workerStats.activeBlobWorkers = 0。
这次排查的最大价值在于,它不是一次“看到内存高就到处 dispose”的修复,而是把每一轮怀疑都变成日志和截图证据,再让代码改动只针对已经被证明的保留链和生命周期漏洞。